Never let your sense of morals prevent you from doing what is right.

23,777 点击次数

分类: AI

  • 开源邮件服务器 – 比Strong还要Strong的Stalwater,迁移bug分析

    今天不是学英语单词,而是介绍一个项目,以及最新版本迁移的超级大bug的解决方法。

    一款安全、可扩展的邮件与协作服务器,提供全面的协议支持 🛡️
    (IMAP、JMAP、SMTP、CalDAV、CardDAV、WebDAV)

    项目地址:https://github.com/stalwartlabs/stalwart

    配套的Web客户端项目地址:https://github.com/bulwarkmail/webmail

    开源,但附带有Enterprise的商业许可。这里最让人哭笑不得的是,官方把Dashboard也纳入了商业许可的范围,不付费是用不了的哦。

    项目好像是2020年开始,然后到昨天2026年10月28日,发布了第一个正式版 v1.0.0。

    而我,为什么要用这么小众的邮件服务器解决方案?

    是因为我在做一个项目,需要测试邮件收发功能,而以前常用的Windows平台下的hmailserver停止开发了,很多当下的新特性都不支持,所以才寻找替代品的,这不,就找到了这个Stalwart。

    对于我而言,免费的功能够我用,部署起来方便(用docker run就行,我主要是为了数据库统一管理,所以数据库连接到我本地的大杂烩数据库上了),就足够了。

    废话就到这里,接下来就进入重点了,在Stalwart为升级1.0.0准备的迁移程序中,存在一个可以说非常严重的bug,具体现象就是:

    原来 v0.16.27 (升级到v1.0.0之前必须是这个版本才可以升级)可以正常登录的账号在升级之后无法登录。

    你说说,你既然都做了迁移程序,最重要的账号居然不能用了,这谁受得了?

    虽然我就两三个测试账号,但是我也不想全新部署啊,初始化的配置实在是太复杂了,我就让Gemini 3.8 High(网页版)一步一步帮我排查,不知不觉就用了一天,快下班的时候,才终于定位到根因。

    升级完Stalwart之后,可以在.env里定义一个admin账号登录应急,所以就暂时中止了。

    等升级完Bulwark发现普通账号还是无法登录,于是就继续排查了,没想到Gemini还真给我解决了,在这里分享一下解决方案吧,能帮一个算一个。

    来自Gemini一锤定音的原文:

    Python

    # Let's inspect x:Account objects in state.sqlite or simulate what x:Account has
    # The user has the Python script already working. Let's see what x:Account has.


    Python

    # Let's write a small script to query x:Account from state.sqlite
    # But wait, we can't query state.sqlite on user machine directly, we provide the python snippet for the user to run,
    # or we see what x:Account has.


    Python

    # Let's write a python script to inspect MySQL tables for 'defaultUserRoleIds'
    script = """
    import pymysql # wait, does python in user environment have pymysql or mysql?
    # In Debian, usually default python has python3-pymysql or we can use mysql CLI with --no-defaults
    """


    解密输出直接暴露了底层最隐蔽的核心 Bug。

    结合刚才所有的证据:

    1. 老账号 admin@xxxxx.net、test@xxxxx.net:密码通过,但被判定 reason = "authenticate"。
    2. 新创账号 biubiu@xxxxx.net:密码通过,依然被判定 reason = "authenticate"。
    3. IMAP 端口(993)直连:密码验证通过后,服务端直接断开连接(errno: 0)。
    4. 环境变量 STALWART_RECOVERY_ADMIN:直接正常登入后台。

    致命根因:迁移程序留下的“幽灵角色指针”

    查看刚刚解密出的 x:Authentication(认证单例配置):

    JSON

    ================= x:Authentication =================
    ID: 0
    {
      "defaultAdminRoleIds": {
        "b": true,
        "e": true
      },
      "defaultGroupRoleIds": {
        "c": true
      },
      "defaultTenantRoleIds": {
        "b": true,
        "d": true
      },
      "defaultUserRoleIds": {
        "b": true
      },
      ...
    }
    

    对比解密出的 x:Role(实际存在的角色对象):

    • ID: 1 —— Description: “User”(拥有全部 IMAP/JMAP/Authenticate 权限)
    • ID: 2 —— Description: “Group”
    • ID: 3 —— Description: “Tenant Administrator”
    • ID: 4 —— Description: “System Administrator”

    问题发生机制

    1. 0.16 时代的残留:在 Stalwart 0.16 中,内置角色的内部标识符是短字符 "b", "c", "d", "e"。
    2. 迁移程序的 Bug:stalwart-migrate 在迁移时,将角色转换成了全新的数字 ID(1, 2, 3, 4),但在迁移 x:Authentication 全局认证配置时,漏掉了外键重映射,仍然记录着:
      • 普通用户默认角色:指向不存在的 b
      • 管理员默认角色:指向不存在的 b 和 e
    3. 权限判定逻辑:在 Stalwart 1.0 的安全模型中,账号上绑定的“User role”或“Admin role”并不是直接内嵌权限集合,而是一个指针——它会到 Authentication 单例中去解析 defaultUserRoleIds。当 kem、admin 或新建的 solo 登录时,系统尝试解析其角色 "b"。因为数据库中根本没有名为 "b" 的角色,系统解析出空列表(0 角色、0 权限)。
    4. 最终表现:无论怎么在页面上修改那个名为 “User”(ID: 1)的角色,由于账号绑定的“User role”解析指向了失效的幽灵 ID "b",所有属于普通用户和管理员的账号全部没有任何权限,在比对完密码的第一时间触发:reason = "authenticate"(无权登录服务器)。而 STALWART_RECOVERY_ADMIN 不经过目录解析,直接在内核中旁路了 RBAC,所以只有它能正常登入。

    解决办法:在 WebAdmin 中重新关联默认角色

    既然已经通过 Recovery Admin 登入了后台,只需将这几个默认角色指针重新点选一次即可(耗时 1 分钟)。

    第一步:打开认证全局设置

    1. 在 Stalwart 管理后台页面顶部,直接在搜索框(或按快捷键 Ctrl + K)输入:defaultUserRoleIds 或 Authentication。(或者在菜单中找到 Settings -> Access Control / Authentication -> General)。

    第二步:修复默认角色绑定

    在该页面中找到以下几项角色设置(目前里面应该显示为空,或显示着失效的红标/旧标识):

    1. Default User Roles(普通用户默认角色):
      • 点开下拉框,选择 User(即 ID 为 1 的那个角色)。
    2. Default Admin Roles(管理员默认角色):
      • 点开下拉框,选择 System Administrator(ID: 4)和 User(ID: 1)。
    3. Default Group Roles:选择 Group(ID: 2)。
    4. Default Tenant Roles:选择 Tenant Administrator(ID: 3)。
    5. 点击页面右下角的 Save 保存。

    第三步:重启容器使角色缓存刷新

    Stalwart 内部对单例角色权限有内存缓存,保存后在终端重启一次容器:

    Bash

    docker restart stalwart-mail
    

    验证放行

    容器重启就绪后,直接在宿主机终端执行:

    Bash

    curl -i -k -u "test@xxxxx.net:这里是password" https://xxx.xxx.xxx.xxx:28443/jmap/session
    

    此时不再会出现 403,而是直接返回 HTTP/2 200 OK 并带出 JMAP Session 会话数据。随后回到 Bulwark 页面(https://xxx.xxx.xxx.xxx:3100),点击登录即可进入邮箱。
  • 拒绝 AI 提前制造“屎山”:使用 CodeX CLI 早期开发的 8 条铁律

    拒绝 AI 提前制造“屎山”:使用 CodeX CLI 早期开发的 8 条铁律

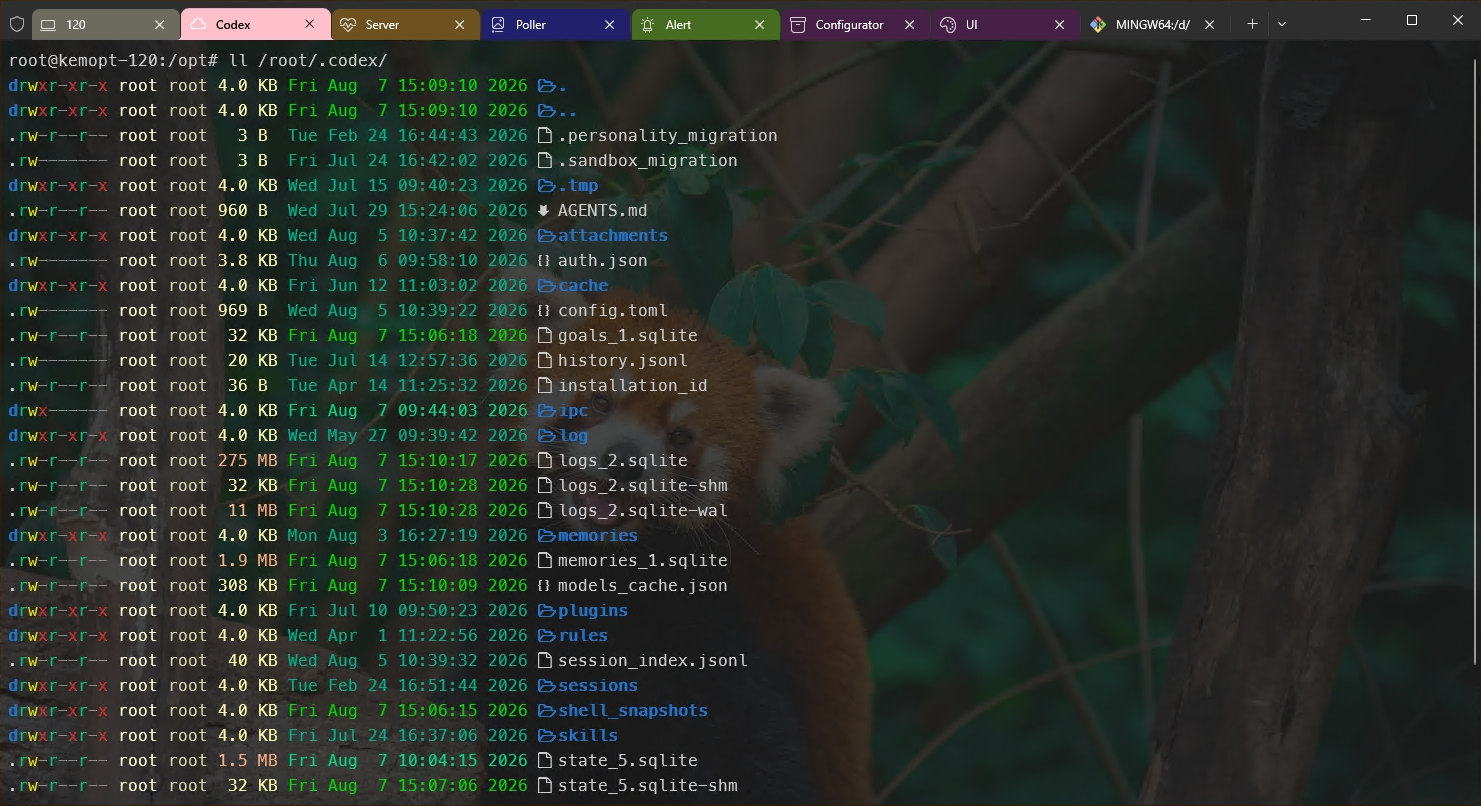
    Vibe Coding快满一年了,踩过无数坑,也从坑里爬出过无数回,本着经济高效的理念,我现在使用的IDE收缩至俩,分别是Antigravity和VS Code,VS Code里接入DeepSeek和Codex,基本满足了我当下的需求。

    但蜜月期很快就结束了。

    当项目脱离了 “Hello World” 阶段,进入核心逻辑的快速迭代期时,我发现了一个极其致命的问题:AI 总是过度表现出一种“企业级”的求生欲。它对于“向后兼容”有着近乎偏执的狂热。

    明明是一个还在开发阶段(Phase 0 到 1)、连内测用户都没有的项目,我仅仅是想在数据库表里删掉一个不再需要的字段,CodeX 竟然给我洋洋洒洒写了一个长达百行的 Migration(数据迁移)脚本,甚至还在 API 层加了一个 Fallback(降级)兼容层!

    这简直是在给还在襁褓中的项目直接注入“十年历史遗留问题”的屎山基因。

    如果你也在用 AI 辅助构建新项目,并且不想在项目上线前就被毫无意义的复杂度压垮,请务必在你的 System Prompt 或 Cursor Rules 里,死死钉住以下 8 条架构决策铁律。

    1. 绝不保留向后兼容:过时的代码只有死路一条

    场景痛点: 假设你在写一个基于 Rust 的后端服务,中途发现早期设计的 DeviceConfig 结构体完全错了。你让 AI 去修改结构。AI 的第一反应往往是保留旧的 DeviceConfigV1,创建一个 DeviceConfigV2,然后写一堆 From trait 来做互相转换。

    我的规矩: 在项目未正式发布(或无外部依赖)前,过时的直接删,别加兼容层、别写 Migration、别留 Fallback。 我们不需要像维护一个有上万并发的在线支付系统那样去维护一个开发环境的数据库。如果表结构变了,直接 DROP TABLE 重新建;如果 API 路由变了,直接改名字。

    把时间浪费在为不存在的旧版本用户写兼容代码,是对开发生命力的极大消耗。

    给 AI 的 Prompt 约束: “本项目正处于 MVP 开发阶段,没有历史包袱。遇到废弃的字段、路由或数据结构,请直接进行破坏性删除(Destructive Deletion),严禁编写任何形式的兼容层、Migration 脚本或 Fallback 逻辑。”

    2. 拒绝预防性抽象:只要能跑的最简实现

    场景痛点: 你想加一个从本地读取 JSON 配置文件的功能。如果任由 AI 发挥,它能给你整出一个 ConfigProvider 接口,然后实现一个 LocalJsonConfigProvider,最后再来一个依赖注入工厂。

    我的规矩: 选能满足当前需求的最简单实现。不要预防性抽象,不要多此一举的配置层。 AI 极其喜欢炫技,它阅读了 GitHub 上成千上万的企业级开源项目,导致它认为“高内聚低耦合 = 疯狂加接口”。但在项目的探索期,过早的抽象是万恶之源。如果只需要读取一个文件,直接用标准的 fs::read_to_string 一把梭。等真的有一天你需要从 AWS S3 读取配置时,再去重构提取接口也不迟。

    代码越少,Bug 越少,AI 再次阅读上下文时消耗的 Token 也越少。

    3. 端到端优先:系统是切出来的,不是叠出来的

    场景痛点: 很多新手带着 AI 写代码,喜欢“分层堆叠”:先让 AI 把所有数据库表建好,然后写所有的 ORM 模型,接着写所有的 Service 逻辑,最后再碰前端。结果往往是底层写了 80% 的无用代码,一旦前端需求变了,整个底层都要推倒重来。

    我的规矩: 先跑通一个最小的端到端版本(Vertical Slice),再往上加东西。绝不为了未完成的复杂度,拆掉能跑的东西。 比如做那个网络自动化巡检系统,第一天我就只要求 AI 做一件事:前端点一个按钮 -> 后端接收请求 -> 通过 SSH 连上一台测试机拉取 uptime -> 回传前端显示。 就这一个极简的端到端切片。中间不搞复杂的任务队列,不搞状态机。

    一旦这条线跑通,系统就“活”了。之后你可以往这根线上挂载“定时任务”、“并发控制”、“复杂解析”,但始终要保证系统处于“可运行”状态。

    4. 强制模块化与关注点分离 (Separation of Concerns)

    场景痛点: AI 在生成长代码时,极其容易把业务逻辑、UI 渲染、甚至环境配置揉在同一个文件里。如果你在开发 WASM 前端,它可能会把组件的样式计算和网络请求死死绑定在一起。

    我的规矩: 虽然我们抵制“预防性抽象”,但这不代表我们可以写“面条代码”。组件必须保持模块化,关注点绝对分离。 把数据获取(Fetch)、状态管理(Store/State)和视图渲染(View)分开。当你告诉 CodeX “帮我修改卡片右上角的编辑图标样式”时,它只应该去改 View 层的代码,而不是重新生成一遍包含数据获取逻辑的整个大组件。

    5. 敬畏开源:优先用成熟的、有人维护的库

    场景痛点: 遇到一个稍微复杂的日期时间格式化,或者特定的字符串正则提取,AI 很多时候会“为了展现聪明才智”当场给你手写一个几百行的解析器。

    我的规矩: 没有明确理由,别自己重写。 遇到常见需求,第一时间去搜轮子。处理时间?去用成熟的包;做反向代理?直接挂 Nginx,别让 AI 在代码里手撸一个 HTTP 代理分发;做进程监控?系统级服务直接上 Systemd,容器级挂 Docker 重启策略,甚至直接用 fail2ban 搞定安全拦截,别在业务代码里写一堆轮询脚本。

    相信世界上最聪明的那拨开源维护者,不要相信 AI 临时在一秒钟内生成的正则。

    6. 榨干现有依赖:别动不动就引入新包

    场景痛点: AI 经常有“依赖饥渴症”。项目里明明已经有了 reqwest,它非要为了发一个简单的 HTTP 请求再让你装一个轻量级的包;明明 tokio 已经提供了定时器,它非要让你引入一个专门的 Cron 包。

    我的规矩: 先翻项目里已有的依赖能做什么,再考虑加新包或自己写。别上来就假设库里没有。 每次引入一个新的包,不仅增加了编译时间(比如在做 Rust 到 WASM 的编译时,LTO 优化的时间极其宝贵),还会增加安全漏洞的攻击面。在给 AI 发出指令前,我通常会附上一句:“检查 Cargo.toml / package.json,仅使用现有依赖完成此功能。”

    7. 架构决策往长了做:拒绝“临时凑合”

    场景痛点: “老板催得紧,这里的数据我们先写死在一个 JSON 文件里吧,以后有空再上数据库。” AI 也很乐意配合你这种短视行为,甚至会为你写一套非常精密的 JSON 文件读写互斥锁。

    我的规矩: 不接受”先这样以后再换”的临时方案。 经验告诉我们,IT 运维系统里的“临时方案”,往往最后都会变成运行了 5 年的“核心基础设施”。如果你知道这个功能最终需要落库查询(比如需要复杂的关系联表、资产树状层级),哪怕现在只有 10 条测试数据,也必须立刻上 SQLite 甚至 PostgreSQL,并搭建好基础的连接池。

    如果一开始的架构方向妥协了,后期迁移数据的痛苦,会让你想要把当初敲下这段代码的键盘砸碎。

    8. 别从零发明:抄成熟产品的作业

    场景痛点: 你需要设计一套 IP 地址管理系统(IPAM)或者设备机柜视图。AI 顺着你的思路,天马行空地设计了一套前所未有的、极其复杂的坐标系数据结构。

    我的规矩: 先看成熟产品怎么解决同一个问题,用已验证的模式。 在这个行业,几乎没有什么是没被人做过的。如果你在做网络自动化系统,不要让 AI 瞎编数据结构,直接告诉它:“去参考 NetBox 的核心数据架构,模仿它对 Site, Rack, Device 的层级抽象定义。” 如果你在做 ITSS 运维管理系统,就直接参考 iTop 的 CMDB 理念。

    站在巨人的肩膀上,然后让 AI 帮你把巨人的思想转化为代码,这才是驾驭 AI 的正确姿势。

    以上要点,汇总到你的AGENTS.md就是:

    注意!

    • 以下提示词仅适用于开发阶段的项目,切勿用于生产环境!
    • 如果你仍在迭代的项目需要频繁的进行数据库开发,第一条中的“别写migration”可以删除。
    1、不保留向后兼容。过时的直接删,别加兼容层、别写migration、别留fallback。
    2、选能满足当前需求的最简单实现。不要预防性抽象,不要多此一举的配置层。
    3、系统分层长。先跑通一个最小的端到端版本,再往上加东西。绝不为了未完成的复杂度拆掉能跑的东西。
    4、组件保持模块化,关注点分离。
    5、优先用成熟的、有人维护的库。没有明确理由别自己重写。
    6、先翻项目里已有的依赖能做什么,再考虑加新包或自己写。别上来就假设库里没有。
    7、架构决策往长了做。不接受"先这样以后再换"的临时方案。
    8、先看成熟产品怎么解决同一个问题,用已验证的模式,别从零发明。

    总结

    AI 是一个阅读过万卷代码,但没有任何真实项目挨骂经验的“超级初级程序员”。它极其勤奋,懂得所有的设计模式,但完全不懂业务的妥协与演进节奏。

    在 AI 编码时代,程序员的核心竞争力不再是写出无 Bug 的循环语句,而是“品味”与“决断力”。我们必须像一个严厉的 Tech Lead,拿着戒尺,随时敲打试图制造屎山的 AI,逼迫它写出克制、精准、能打硬仗的代码。

    你对 AI 编码工具的态度是怎样的?欢迎在评论区分享你被 AI “坑”过的实战经历。

  • Cherry Studio更新慢了,Lobe-chat活力依旧

    Cherry Studio更新慢了,Lobe-chat活力依旧

    这Cherry Studio,自从前段时间开始商业化之后更新就慢了呀。

    还是Lobe-chat爽啊,Beta分支一天更新好几个版本。

    现在的Lobe-chat-database版已经稳定运行数月,基于Docker部署,综合来说还是比较满意的,缺点也是有点的,目前总结下来有以下两点:

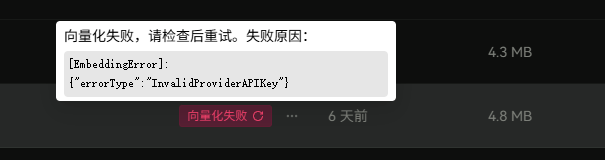
    • 修改嵌入模型之后(在自己选择的大模型提供商中增加嵌入模型),之前在环境变量中指定的嵌入模型就失效了,知识库里如果想向量化文档就会各种失败了。解决方法似乎是只能是重新部署一遍。
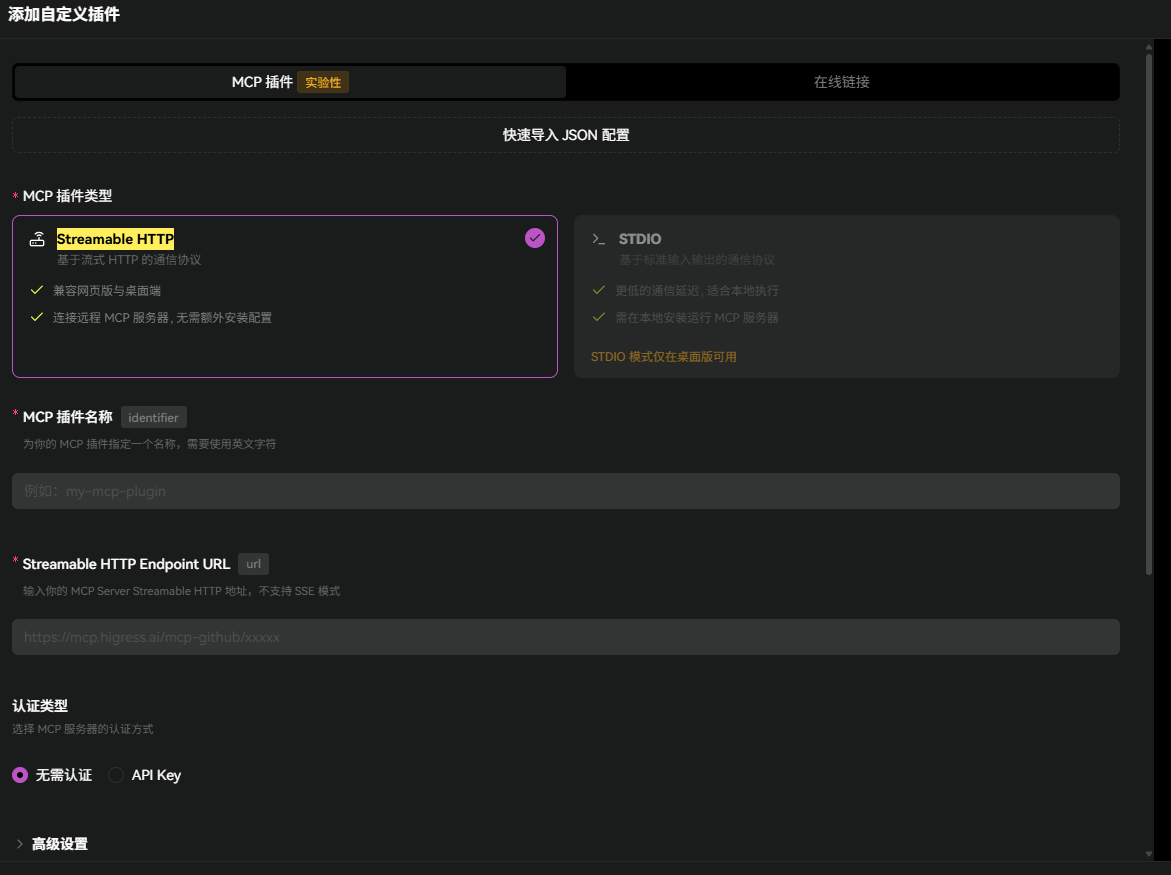
    • 另一个问题就是web版的lobe-chat不支持用STDIO模式的MCP就很痛苦了。基于Streamable HTTP的MCP不如STDIO的多,尤其是那些常用的,比如ChromeDevTools。
    • 还有一个问题就是token量一大的时候,页面就有些卡了,这个似乎也没办法。

    综合下来,lobe-chat还是比较适合日常用的,Cherry Studio目前基本上就是吃土的状态了,除非要用某些MCP调试网页的时候才会打开了。

  • ChromeDevTools路径问题修改

    ChromeDevTools路径问题修改

    抛开在改版时ChromeDevTools的无效帮助不说,这东西还是很有用的。

    但如果你的Chrome不是安装在默认的C盘路径下,就会无法调用这个MCP,怎么办呢?很简单,加参数:

    -e="D:\Program Files\Chrome\Application\chrome.exe"

    完整版json如下:

    {
      "mcpServers": {
        "chrome-devtools": {
          "command": "npx",
          "args": [
            "chrome-devtools-mcp@latest",
            "-e=\"D:\\Program Files\\Chrome\\Application\\chrome.exe\""
          ]
        }
      }
    }

    另外遇到的一个问题是版本的变化有可能会重置参数哦。

    昨天ChromeDevTools的版本是0.6,今天一来就是0.8了,开始没注意,又跟昨天一样调用失败了,于是去CherryStudio里看了一眼,原来是参数没了,重新加上就可以了。

    所以需要用这个MCP的小伙伴记得妥善保存好这个参数哦,并且时刻关注GitHub上的release log,说不定后面的版本会修复,这个参数就不再需要了。

    有用的话记得回来评论感谢我哦!